La evolución de las redes delictivas en el sector financiero ha superado las capacidades operativas de las reglas de negocio estáticas y los modelos de aprendizaje automático aislados. Los esquemas modernos de fraude, como las redes de «mulas de dinero», el fraude de identidad sintética y el blanqueo de capitales estructurado (smurfing), operan canalizando activos a través de múltiples cuentas intermediarias para enmascarar el origen del dinero. Mientras que los algoritmos tradicionales analizan cada transacción de forma independiente, las Graph Neural Networks (GNN) permiten modelar explícitamente las topologías de conexión, identificando patrones anómalos en las relaciones entre entidades (cuentas, dispositivos, direcciones IP y tarjetas). Este artículo aborda la fundamentación matemática, la arquitectura de sistemas en tiempo real y la implementación en Python de una solución antifraude basada en GNNs.
Límites de la Machine Learning Tradicional en Entornos Multicapa
Los sistemas de detección de fraude basados en modelos tabulares —como XGBoost, LightGBM o redes neuronales perceptrón multicapa (MLP)— dependen intrínsecamente de la ingeniería de características (feature engineering) manual para capturar el contexto del usuario. Se crean variables agregadas del tipo «número de transferencias en las últimas 24 horas» o «desviación del importe promedio».
Este enfoque presenta tres vulnerabilidades estructurales frente al fraude organizado:
- Pérdida de relaciones de orden superior: Un modelo tabular no puede evaluar de forma nativa la topología a N saltos de distancia. Si la Cuenta A transfiere fondos a la Cuenta B, y esta inmediatamente envía fondos a la Cuenta C (que está marcada como sospechosa), un clasificador tradicional procesa cada evento sin comprender el flujo directo A > B > C.
- Alta dimensionalidad e ineficiencia: Para capturar conexiones complejas sin grafos, los ingenieros deben realizar uniones masivas (SQL joins) sobre tablas gigantescas, generando un alto costo computacional incompatible con las exigencias de latencia sub-segundo (<100 ms).
- Vulnerabilidad ante la identidad sintética: Los atacantes evaden los límites individuales abriendo cientos de cuentas legítimas en apariencia que operan por debajo de los umbrales de alerta, activándose de forma coordinada solo en el momento del ataque.
Fundamentos de GNN Aplicados a Redes Transaccionales
Las Graph Neural Networks superan estas limitaciones procesando directamente estructuras de datos representadas como grafos orientados y ponderados.
Transformación de Bases de Datos Relacionales a Grafos G = (V, E)
Un dominio financiero se define como un grafo heterogéneo G = (V, E, Tv, Te)$, donde:
- V (Vértices/Nodos): Representan las entidades del sistema. Tienen un tipo t Tv (ej.
Cuenta,Dispositivo,Dirección IP,Tarjeta de Crédito). Cada nodo posee un vector de características iniciales xv Rd (ej. antigüedad de la cuenta, balance, puntuación de crédito). - E (Aristas/Enlaces): Representan las interacciones o transacciones entre entidades con tipo r Te (ej.
TRANSFIERE_A,USA_DISPOSITIVO,COMPARTE_IP). Cada arista eu,v contiene atributos eu,v (ej. monto, timestamp, geolocalización).
  [Cuenta A] --- (USA_DISPOSITIVO) ---> [Dispositivo X] <--- (USA_DISPOSITIVO) --- [Cuenta B]
       |                                                                                |
(TRANSFIERE)                                                                      (TRANSFIERE)
       v                                                                                v
  [Cuenta C] ----------------------- (TRANSFIERE_A) ----------------------------> [Cuenta D]
Algoritmos Clave: GraphSAGE y Graph Convolutional Networks (GCN)
El principio operativo subyacente en las GNN es el Passage de Mensajes (Message Passing). En cada capa de la red, un nodo recopila los vectores de características de sus vecinos inmediatos, los agrega mediante una función permutable (invariante al orden) y actualiza su propio estado latente.
Formalmente, la representación del nodo v en la capa k+1, denotada como hv(k+1), se calcula como:
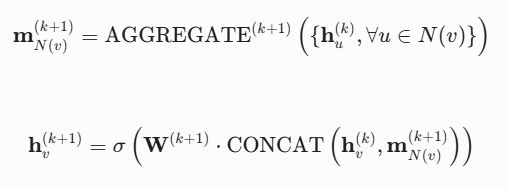
Donde:
- N(v) es el conjunto de vecinos del nodo v.
- AGGREGATE es una función como
MEAN,MAX, oLSTM. - W(k+1) es una matriz de pesos entrenable.
- o es una función de activación no lineal (ej. ReLU o LeakyReLU).
En arquitecturas escalarmente eficientes como GraphSAGE (Sample and Aggregate), en lugar de procesar todo el grafo (lo cual es inviable en redes de millones de nodos), se realiza un muestreo aleatorio uniforme de un número fijo de vecinos para cada nodo, garantizando un footprint de memoria acotado durante el entrenamiento por mini-lotes (mini-batching).
Arquitectura del Sistema de Inferencia en Tiempo Real
Para operar un sistema de detección de fraude en tiempo real basado en GNN dentro de una infraestructura FinTech, se requiere una separación clara entre el procesamiento de eventos de baja latencia y el reentrenamiento asíncrono de los modelos.
+-----------------------------------------------------------------------------------+
|                                FLUJO DE DATOS EN TIEMPO REAL                      |
+-----------------------------------------------------------------------------------+
   [Cliente / App]
          |
          v
   [API Gateway] ----> [Transaction Service]
                               |
                               v (Evento de Transacción)
                        [Apache Kafka]
                               |
                   +-----------+-----------+
                   |                       |
                   v                       v
         [Feature Store (Redis)]   [Graph Engine (Neo4j / Memgraph)]
                   |                       |
                   +-----------+-----------+
                               |
                               v
                     [GNN Inference Engine]
                   (Triton / PyTorch C++)
                               |
                               v (Score de Fraude)
                     [Motor de Decisiones] ---> [Bloqueo / Step-Up Auth]
- Ingesta de Transacciones: Cada solicitud de pago se publica en un bus de eventos de alto rendimiento (Apache Kafka).
- Actualización de la Base de Datos de Grafos: Un consumidor en tiempo real inserta el evento en una base de datos en memoria orientada a grafos (Memgraph o Neo4j), actualizando las conexiones en milisegundos.
- Mapeo de Subgrafo y Extracción de Características: El servicio de inferencia consulta el subgrafo local a k-saltos alrededor de los actores involucrados en la transacción, combinándolo con las características dinámicas del nodo almacenadas en Redis.
- Inferencia GNN: La topología extraída se envía a un servidor de inferencia (Triton Inference Server o ejecutable PyTorch C++ LibTorch), devolviendo una probabilidad de fraude (P(fraude) = [0, 1]).
- Toma de Decisión: Si la probabilidad supera un umbral crítico (ej. 0.85), la transacción se bloquea automáticamente o se exige una autenticación reforzada (MFA).
Implementación Práctica: Pipeline de Detección con PyTorch Geometric
A continuación se presenta un pipeline completo que utiliza PyTorch y PyTorch Geometric (PyG) para construir un modelo de clasificación de nodos en un grafo heterogéneo sintético que simula cuentas y transacciones financieras.
1. Construcción del Grafo de Transacciones
Python
import torch
from torch_geometric.data import HeteroData
import torch.nn.functional as F
from torch_geometric.nn import SAGEConv, to_hetero

# 1. Definición del objeto de datos heterogéneo
data = HeteroData()

# Supongamos 10,000 cuentas de usuario y 500 dispositivos compartidos
num_users = 10000
num_devices = 500

# Características de las cuentas: [antigüedad_días, scoring_interno, volumen_habitual]
data['user'].x = torch.randn(num_users, 3)

# Características de los dispositivos: [tipo_os, es_vpn, recuento_intentos]
data['device'].x = torch.randn(num_devices, 3)

# Etiquetas de fraude para los usuarios (0: Legítimo, 1: Fraudulento)
# Supongamos una clase altamente desbalanceada (1% de fraude)
labels = torch.zeros(num_users, dtype=torch.long)
fraud_indices = torch.randint(0, num_users, (100,))
labels[fraud_indices] = 1
data['user'].y = labels

# Definición de Aristas: 'user' TRANSFIERE_A 'user'
# Generación de 50,000 transacciones aleatorias
src_users = torch.randint(0, num_users, (50000,))
dst_users = torch.randint(0, num_users, (50000,))
data['user', 'transfers', 'user'].edge_index = torch.stack([src_users, dst_users], dim=0)

# Definición de Aristas: 'user' USA 'device'
user_dev = torch.randint(0, num_users, (15000,))
device_dev = torch.randint(0, num_devices, (15000,))
data['user', 'uses', 'device'].edge_index = torch.stack([user_dev, device_dev], dim=0)

print(data)
2. Definición del Modelo Heterogéneo de GNN
Utilizamos una arquitectura GraphSAGE adaptada para tipos de nodos y relaciones heterogéneas mediante la transformación to_hetero.
Python
class HomogeneousGNN(torch.nn.Module):
    def __init__(self, hidden_channels, out_channels):
        super().__init__()
        # Capa 1: Agregación de características de primer orden
        self.conv1 = SAGEConv((-1, -1), hidden_channels)
        # Capa 2: Agregación de características de segundo orden
        self.conv2 = SAGEConv((-1, -1), out_channels)

    def forward(self, x, edge_index):
        x = self.conv1(x, edge_index)
        x = F.relu(x)
        x = F.dropout(x, p=0.2, training=self.training)
        x = self.conv2(x, edge_index)
        return x

# Instanciación y conversión a heterogéneo
hidden_dim = 64
num_classes = 2  # Legítimo vs Fraudulento

base_model = HomogeneousGNN(hidden_channels=hidden_dim, out_channels=hidden_dim)
model = to_hetero(base_model, data.metadata(), aggr='sum')

# Cabezal de clasificación para el nodo objetivo 'user'
class FraudClassifier(torch.nn.Module):
    def __init__(self, gnn_model, hidden_dim, num_classes):
        super().__init__()
        self.gnn = gnn_model
        self.classifier = torch.nn.Linear(hidden_dim, num_classes)

    def forward(self, x_dict, edge_index_dict):
        # Generar embeddings de representación gráfica
        h_dict = self.gnn(x_dict, edge_index_dict)
        # Clasificar únicamente los nodos de tipo 'user'
        out = self.classifier(h_dict['user'])
        return out

final_model = FraudClassifier(model, hidden_dim, num_classes)
print(final_model)
3. Entrenando la Red y Evaluación de Métricas
Dada la asimetría de las clases en la detección de fraude, la función de pérdida debe compensar el desbalanceo mediante ponderación de clases (CrossEntropyLoss ponderada) o priorizando métricas como Precision-Recall AUC (PR-AUC) sobre la exactitud (Accuracy).
Python
from sklearn.metrics import roc_auc_score, precision_recall_curve, auc
import numpy as np

optimizer = torch.optim.Adam(final_model.parameters(), lr=0.01, weight_decay=1e-4)

# Peso para la clase minoritaria (Fraude)
class_weights = torch.tensor([1.0, 50.0])
criterion = torch.nn.CrossEntropyLoss(weight=class_weights)

# Máscaras de entrenamiento y prueba
train_mask = torch.zeros(num_users, dtype=torch.bool)
test_mask = torch.zeros(num_users, dtype=torch.bool)
train_mask[:8000] = True
test_mask[8000:] = True

def train():
    final_model.train()
    optimizer.zero_grad()
    out = final_model(data.x_dict, data.edge_index_dict)
    loss = criterion(out[train_mask], data['user'].y[train_mask])
    loss.backward()
    optimizer.step()
    return loss.item()

@torch.no_grad()
def evaluate():
    final_model.eval()
    out = final_model(data.x_dict, data.edge_index_dict)
    probs = F.softmax(out[test_mask], dim=1)[:, 1].cpu().numpy()
    y_true = data['user'].y[test_mask].cpu().numpy()

    roc_auc = roc_auc_score(y_true, probs)
    precision, recall, _ = precision_recall_curve(y_true, probs)
    pr_auc = auc(recall, precision)

    return roc_auc, pr_auc

# Ciclo de entrenamiento
for epoch in range(1, 101):
    loss = train()
    if epoch % 20 == 0:
        roc_auc, pr_auc = evaluate()
        print(f'Época: {epoch:03d} | Pérdida: {loss:.4f} | ROC-AUC: {roc_auc:.4f} | PR-AUC: {pr_auc:.4f}')
Comparativa Tecnológica: Enfoques de Detección de Fraude
| Criterio | Reglas de Negocio Estáticas | XGBoost / Gradient Boosting | Graph Neural Networks (GNN) |
| Modelado de Relaciones | Nulo (reglas punto a punto). | Limitado a variables tabulares agregadas manuales. | Nativo en múltiples saltos (N-hops). |
| Resistencia al Fraude Estructurado | Muy baja. Fácilmente eludible. | Media. Sensible a variaciones puntuales. | Alta. Detecta la estructura topológica global. |
| Latencia de Inferencia | < 5 ms | 10 – 30 ms | 30 – 90 ms (requiere optimización de subgrafos). |
| Complejidad de Mantenimiento | Inmanejable a gran escala (miles de reglas). | Baja-Media (reentrenamiento de tablas). | Media-Alta (infraestructura de grafos dedicada). |
| Costo de Computación | Mínimo (CPU estándar). | Moderado (CPU/GPU). | Elevado (requiere aceleración GPU / bases de datos de grafos). |
Estrategias de Despliegue Empresarial y Mitigación de Latencia
Para que un modelo de GNN cumpla con los SLAs (Service Level Agreements) estrictos de una red de pagos como Visa, Mastercard o un sistema de pagos instantáneos (ej. Bizum, SEPA Instant), deben aplicarse las siguientes optimizaciones arquitectónicas:
- Sub-graph Sampling Dinámico: En lugar de cargar todo el grafo financiero durante la inferencia, utilice algoritmos de Neighbor Sampling restringidos a k =2 saltos y un máximo de 10 a 15 vecinos por nodo. Esto reduce la latencia de construcción del grafo de forma exponencial.
- Representaciones Pre-calculadas (Temporal Graph Embeddings): Emplee arquitecturas como TGN (Temporal Graph Networks) para calcular embeddings estables de los nodos en procesos en segundo plano. Al momento de la transacción en vivo, el modelo solo ejecuta una pasada hacia adelante (forward pass) liviana combinando el embedding histórico con las características del evento actual.
- Cuantización y Compilación ONNX / TensorRT: Exporte el modelo de PyTorch Geometric a formato ONNX y aplique cuantización a precisión mixta (FP16 o INT8). Esto permite reducir los tiempos de ejecución del modelo a cifras sub-10ms sobre unidades de procesamiento gráfico (GPU) dedicadas.
Preguntas Frecuentes (FAQ)
¿Cómo manejan las GNN el problema del desbalance de clases extremo en el fraude?
Las GNN abordan el desbalance extremo utilizando funciones de pérdida ponderadas (como Focal Loss o Weighted Cross-Entropy), aplicando técnicas de submuestreo topológico en los nodos legítimos durante la fase de Message Passing, o utilizando módulos de aprendizaje autosupervisado para preentrenar las representaciones de los nodos antes de la fase de ajuste fino (fine-tuning).
¿Cuál es la diferencia entre un algoritmo de comunidad (como Louvain) y una GNN en detección de fraude?
Los algoritmos tradicionales de detección de comunidades como Louvain o PageRank son métodos puramente estructurales no supervisados; identifican agrupaciones basadas únicamente en la densidad de las aristas. Las GNN combinan tanto la topología del grafo como las características complejas multidimensionales de los nodos y aristas mediante un aprendizaje supervisado o semi-supervisado.
¿Se pueden utilizar GNNs si los datos transaccionales no están almacenados en una base de datos de grafos?
Sí. Los datos almacenados en almacenes de datos relacionales (como PostgreSQL) o analíticos (como Snowflake o BigQuery) pueden transformarse en estructuras de grafos en memoria al vuelo durante los procesos de entrenamiento e inferencia mediante librerías como PyTorch Geometric o DGL (Deep Graph Library), utilizando pipelines de extracción optimizados.
Descargo de responsabilidad: Este contenido es exclusivamente formativo e informativo. No constituye asesoramiento financiero, legal ni una recomendación directa para la arquitectura final de sistemas de producción sin previa auditoría de ciberseguridad y riesgos operacionales por parte de personal certificado.